Le jeudi 12 novembre 2026, à 16 h 20 UTC (17 h 20 à Paris), Exchange Online a cessé de répondre à la plupart de ses utilisateurs, dans le monde entier. Microsoft compte 23 heures et 50 minutes d’incident. Pour en sortir, il a fallu annuler un correctif déployé en juillet. Ce dossier reconstitue l’incident à partir du rapport préliminaire de Microsoft, le confronte aux mesures de Downdetector et à la presse, et en tire ce qu’un administrateur peut préparer dès cette semaine.
L’incident en une page
Microsoft suit l’événement sous deux identifiants du centre d’administration Microsoft 365. EX1550543 couvre Exchange Online, ouvert à 16 h 20 UTC, et MO1550821 les autres services, ouvert à 18 h 27 UTC. La liste des services touchés compte Exchange, Copilot, Teams, SharePoint, OneDrive, Defender, Purview, Fabric, Intune, Planner, Power Apps, To Do, Power BI et Universal Print.
L’impact principal a frappé Exchange Online. La plupart des utilisateurs ne pouvaient plus ouvrir leur boîte depuis Outlook, Outlook sur le web, Exchange ActiveSync ou les API de messagerie, et la distribution du courrier a pris du retard. Les autres services restaient pour la plupart en ligne, mais leurs fonctions adossées à Exchange Online ne répondaient plus.
Le rapport préliminaire (Preliminary Post Incident Report) est daté du 15 novembre 2026. Le compte @MSFT365Status a annoncé sa publication le 16 novembre, et Charles Lamanna, vice-président exécutif de Microsoft chargé de Copilot, des agents et de la plateforme, en a diffusé le même jour une version abrégée sur X. Le rapport définitif est annoncé pour le 20 novembre 2026. Ce dossier s’appuie sur le préliminaire, et tout ce qui suit peut encore bouger.
Trois précisions évitent les contresens. Microsoft a déclaré pendant la panne n’avoir aucune preuve d’activité malveillante. Azure n’est pas en cause, et son historique de statut ne contenait, à la date de vérification, aucun rapport post-incident pour ces deux jours. La panne est survenue deux jours après le Patch Tuesday du 10 novembre, et aucune communication de Microsoft ne relie les deux événements, pas plus que le correctif Outlook de ce cycle, détaillé dans ma brève sur la faille NTLM exploitée.
Informations vérifiées le 17 novembre 2026. Le rapport préliminaire est réservé aux administrateurs. Je l’ai lu dans une copie diffusée par un site tiers, identique à la version abrégée de Charles Lamanna sur tous les passages communs.
Une passerelle réseau unique devant Exchange Online
Microsoft 365 ne reçoit pas les connexions de ses clients directement sur les serveurs de boîtes aux lettres. Une passerelle réseau (networking gateway) se tient devant de nombreux services, accepte les connexions, négocie leur établissement, puis les transmet au service visé. Elle tourne sur des serveurs Windows.
Il en existe deux, indépendantes et hétérogènes, conçues pour l’isolation et la haute disponibilité. Un service bascule de l’une à l’autre en cas d’incident, et cette bascule relève de l’exploitation ordinaire. La passerelle dite primaire porte Exchange Online. L’autre accueillait Teams jusqu’à la nuit du 11 au 12 novembre.
La passerelle se compose de milliers d’unités de capacité, organisées en régions. Entre ces partitions, des cloisons (bulkheads, au sens naval) doivent arrêter une défaillance avant qu’elle ne gagne la région voisine. Un système de gestion du trafic détecte les serveurs muets et renvoie leurs utilisateurs vers des points de terminaison sains.
Une phrase du rapport explique la suite. Teams, OneDrive, SharePoint et les applications Office peuvent quitter la passerelle défaillante, Exchange Online ne le peut pas, « pour des raisons d’échelle ».
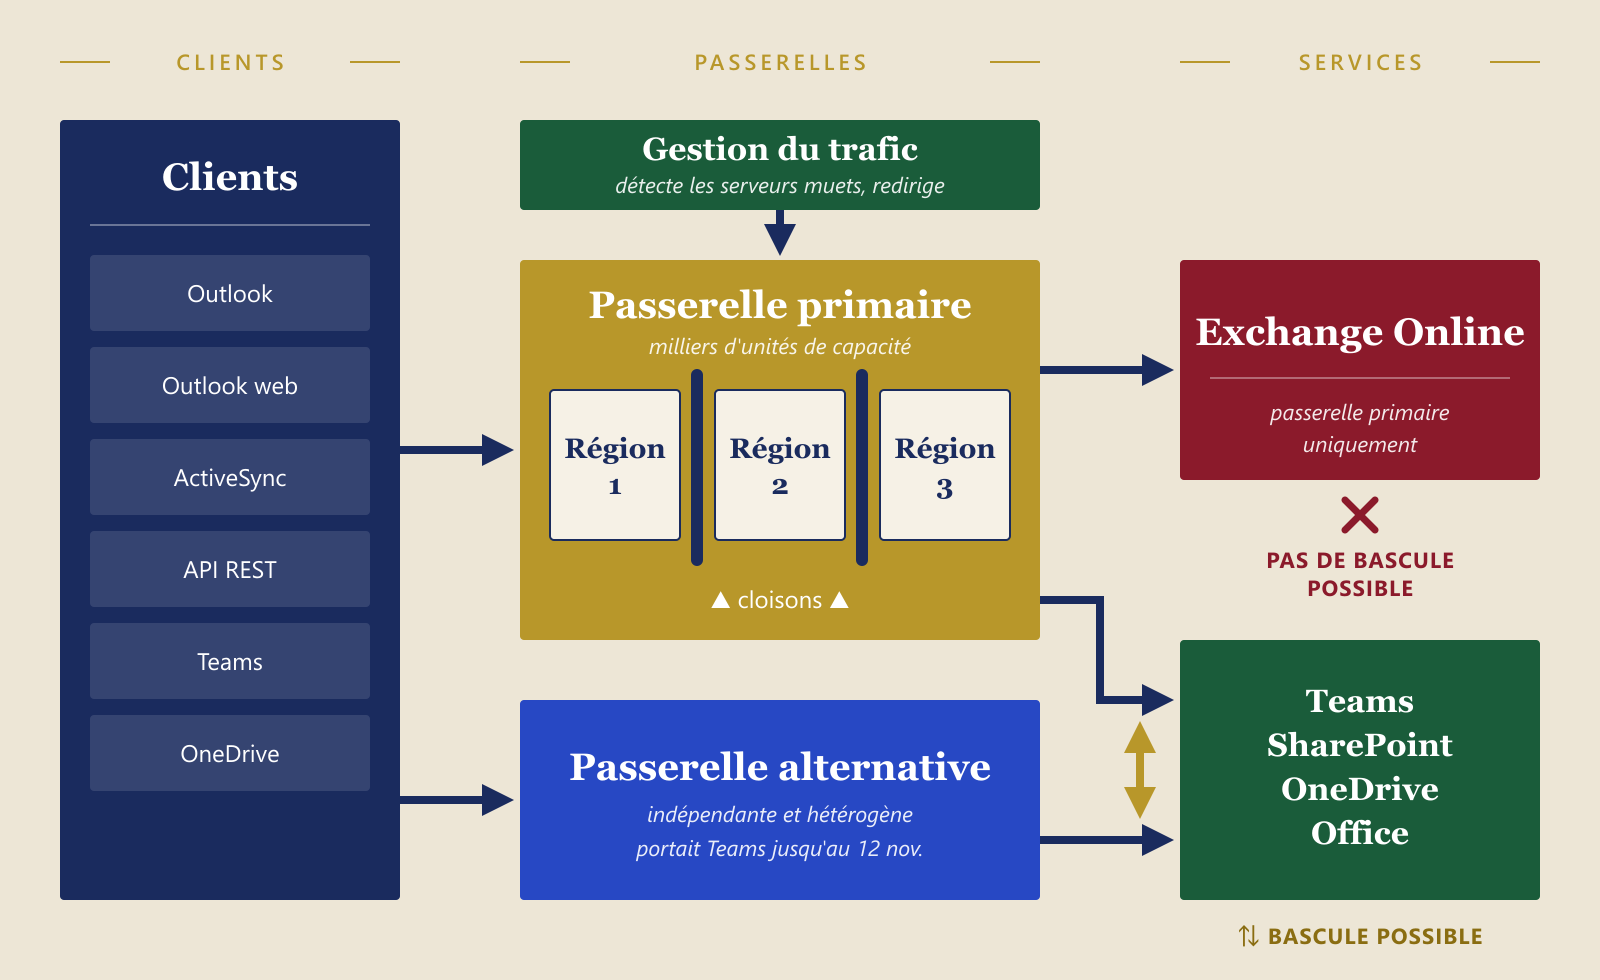 Schéma 1 : architecture de la passerelle réseau devant Microsoft 365, Exchange Online sans bascule possible.
Trois facteurs, aucun suffisant seul
Le rapport attribue la panne à trois facteurs qui, isolés, n’auraient rien provoqué.
Le premier est un défaut latent. Un correctif préparé pour les seuls serveurs de la passerelle a introduit une contention de verrou dans un processus interne de Windows. Sous certaines conditions de charge, des tâches concurrentes s’attendaient sur une ressource partagée jusqu’à épuiser processeur et mémoire. Déployé à partir de juillet 2026, le changement a franchi le déploiement progressif (safe deployment), s’est généralisé en quelques semaines et a tourné plus de trois mois sans incident. Les tests de charge portaient surtout sur du matériel plus faible, avec moins de cœurs, alors que la contention s’aggrave sur les machines récentes qui en ont davantage. Le laboratoire ne reproduisait pas non plus la composition du trafic de production.
Le deuxième est une hausse de charge. À 01 h 07 UTC le 12 novembre, quinze heures avant la panne, la bascule automatique a déplacé le trafic Teams vers la passerelle primaire, celle d’Exchange Online. La charge a monté, et la composition du trafic a changé.
Le troisième est une capacité amputée. Près de 14 % des serveurs de la passerelle étaient hors service depuis la veille, pour une raison que le rapport dit sans lien avec l’incident. La marge restante suffisait, seule, à absorber cette perte.
Réunis, ces facteurs ont réveillé le défaut de juillet au pic du trafic américain. Les requêtes se sont accumulées jusqu’à ce que les serveurs cessent de répondre. La gestion du trafic a fait ce pour quoi elle existe, en renvoyant les utilisateurs vers les serveurs encore sains, et c’est elle qui a propagé la panne. Chaque redirection versait la même charge sur moins de machines. En moins de deux heures, le défaut a gagné toute la flotte, et au plus bas plus de 80 % des serveurs ne répondaient plus.
Les cloisons auraient dû arrêter la cascade à la frontière d’une région. Elles ne l’ont pas fait, « en raison d’un problème distinct » que le rapport ne décrit pas. La panne est devenue mondiale à cet endroit.
La remise en service a buté sur le même mécanisme, car un serveur redémarré recevait aussitôt le trafic en attente et retombait. La récupération automatique n’avait pas été conçue pour un parc entier hors d’état de répondre. Le retour arrière, le flighting et les feature flags ne permettaient pas d’annuler vite un code installé depuis quatre mois. Les ingénieurs ont écrit une mise à jour qui rétablissait le chemin de code Windows antérieur, puis l’ont appliquée par groupes de serveurs, parfois plus de la moitié d’une région à la fois.
Le rapport préliminaire parle d’un processus interne de Windows. La version abrégée publiée par Charles Lamanna dit seulement « processus interne », et retire aussi le mot Windows des serveurs et du code rétabli. Cyber Security News a titré sur un bug Windows caché. Les deux textes de Microsoft gardent la même phrase sur le point qui vous concerne : ni le défaut ni le correctif ne s’appliquent aux autres déploiements de Windows. Il n’y a rien à corriger sur vos serveurs ni sur vos postes.
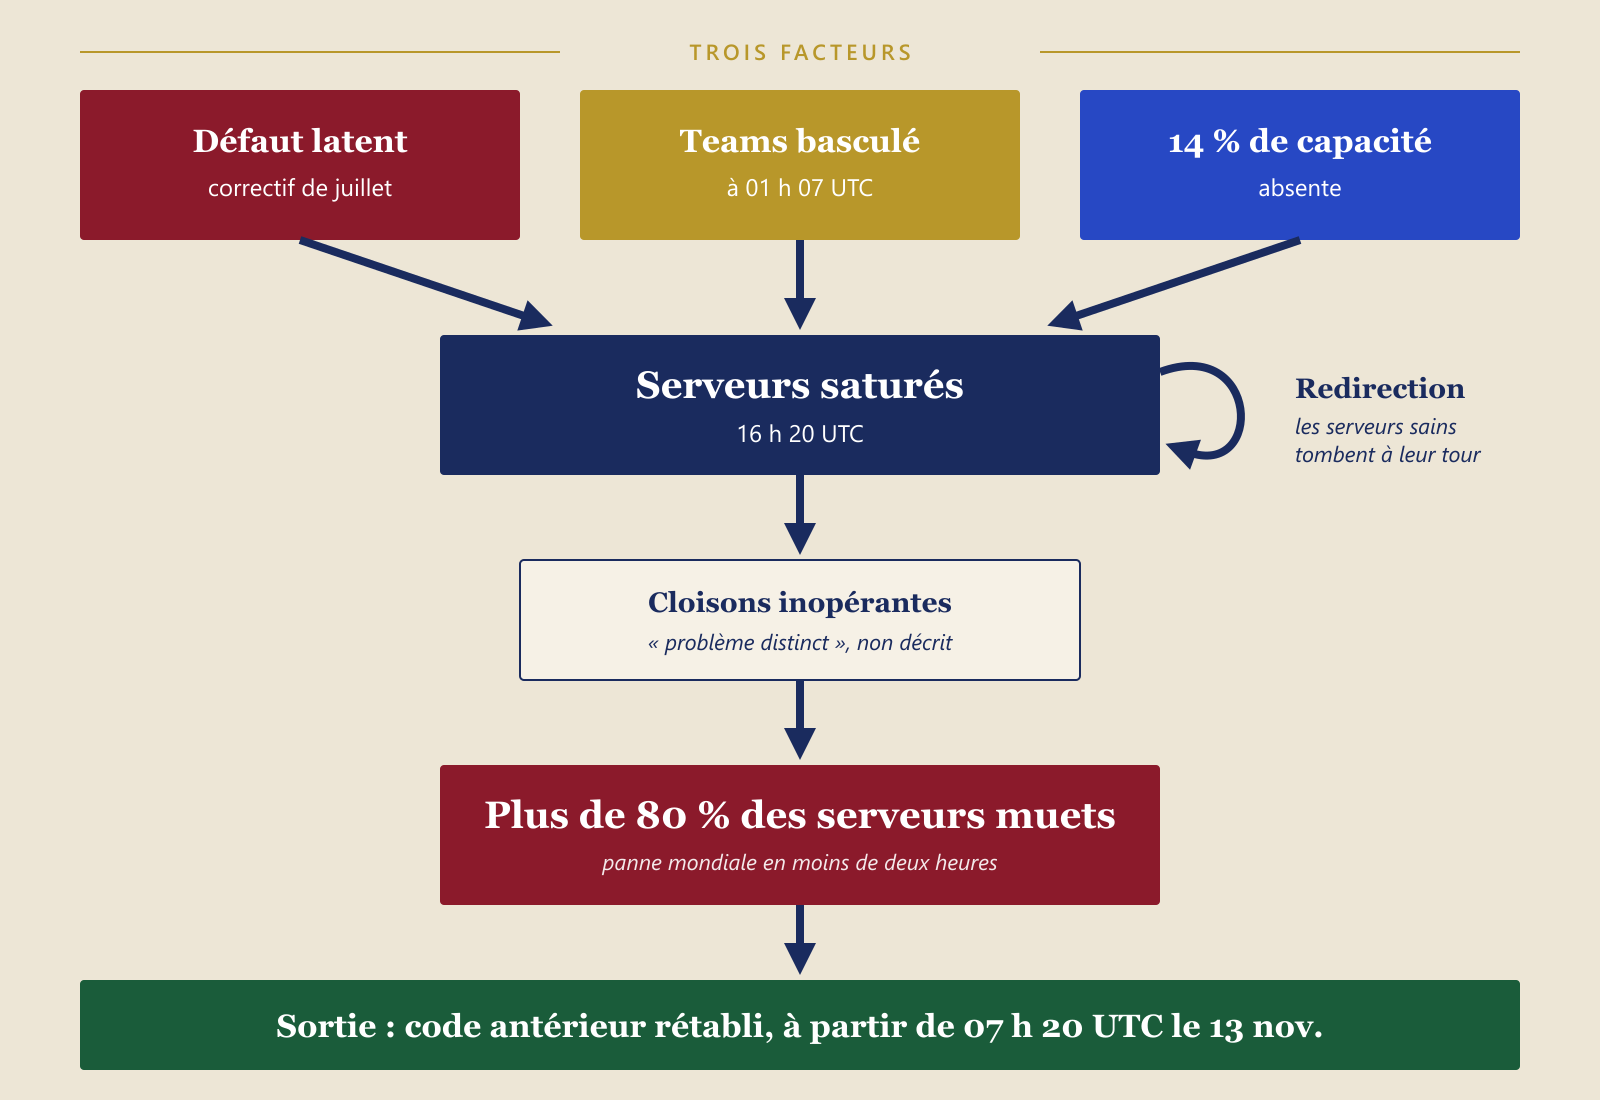 Schéma 2 : trois facteurs, une saturation, une cascade mondiale.
Chronologie heure par heure
Le tableau suit la section « Actions Taken » du rapport préliminaire. Paris était à UTC+1. La ligne Downdetector provient de son propre relevé publié sur X.
| Date | UTC | Paris | Événement |
|---|---|---|---|
| 12 nov. | 01 h 07 | 02 h 07 | Le trafic Teams bascule sur la passerelle partagée avec Exchange Online |
| 12 nov. | 16 h 03 | 17 h 03 | La détection d’anomalies relève une hausse des problèmes de connectivité |
| 12 nov. | 16 h 17 | 17 h 17 | L’automatisation redirige le trafic vers des points sains |
| 12 nov. | 16 h 20 | 17 h 20 | Alerte haute priorité, ouverture de EX1550543 |
| 12 nov. | 16 h 33 | 17 h 33 | Premier ticket client, premiers signalements sur Downdetector |
| 12 nov. | 18 h 25 | 19 h 25 | Downdetector compte 19 650 signalements par minute (cinq services cumulés) |
| 12 nov. | 18 h 27 | 19 h 27 | Ouverture de MO1550821 (Teams, Copilot, Defender) |
| 12 nov. | 19 h 00 | 20 h 00 | Gel de tous les déploiements et changements de configuration |
| 12 nov. | 19 h 20 | 20 h 20 | La charge vient des serveurs indisponibles, pas d’une hausse du trafic |
| 12 nov. | 22 h 00 | 23 h 00 | Constat d’échec des actions engagées |
| 12 nov. | 23 h 55 | 00 h 55 | Les serveurs relancés retombent dès qu’ils reçoivent du trafic |
| 13 nov. | 01 h 00 | 02 h 00 | Le processus qui établit les connexions est identifié comme saturé |
| 13 nov. | 07 h 20 | 08 h 20 | Mise à jour annulant le changement fautif, sur une partie du parc |
| 13 nov. | 11 h 35 | 12 h 35 | Disponibilité revenue à un niveau sain en Europe |
| 13 nov. | 14 h 17 | 15 h 17 | Webmail revenu au niveau attendu dans le monde |
| 13 nov. | 16 h 10 | 17 h 10 | Fin de l’impact actif, résorption des files |
| 14 nov. | 04 h 15 | 05 h 15 | Dernières mises à jour sur EX1550543 et MO1550821 |
La chronologie se découpe en cinq temps. L’incubation dure quinze heures, de la bascule de Teams aux premières alertes, et ne se signale que par des défaillances isolées que l’automatisation traite une à une. L’effondrement prend deux heures, pendant lesquelles l’automatisation aggrave ce qu’elle croit soigner. Vient une nuit de tâtonnements (contournement du contrôle de santé, redémarrages, nouvelle méthode de contrôle) jusqu’au constat de 23 h 55. Le diagnostic tombe vers 01 h 00 UTC. Le correctif part à 07 h 20 UTC, quinze heures après le début officiel, et met neuf heures à faire le tour du globe, Asie-Pacifique d’abord, Europe ensuite.
Les heures de départ divergent. Downdetector attribue à Microsoft un début à 16 h 17 UTC, l’heure des premières redirections automatiques dans le rapport. La presse donne des heures comprises entre 17 h 00 et 18 h 30 UTC selon le message de statut lu, vers 18 h 00 pour The Register. Ce dossier retient les heures du rapport préliminaire.
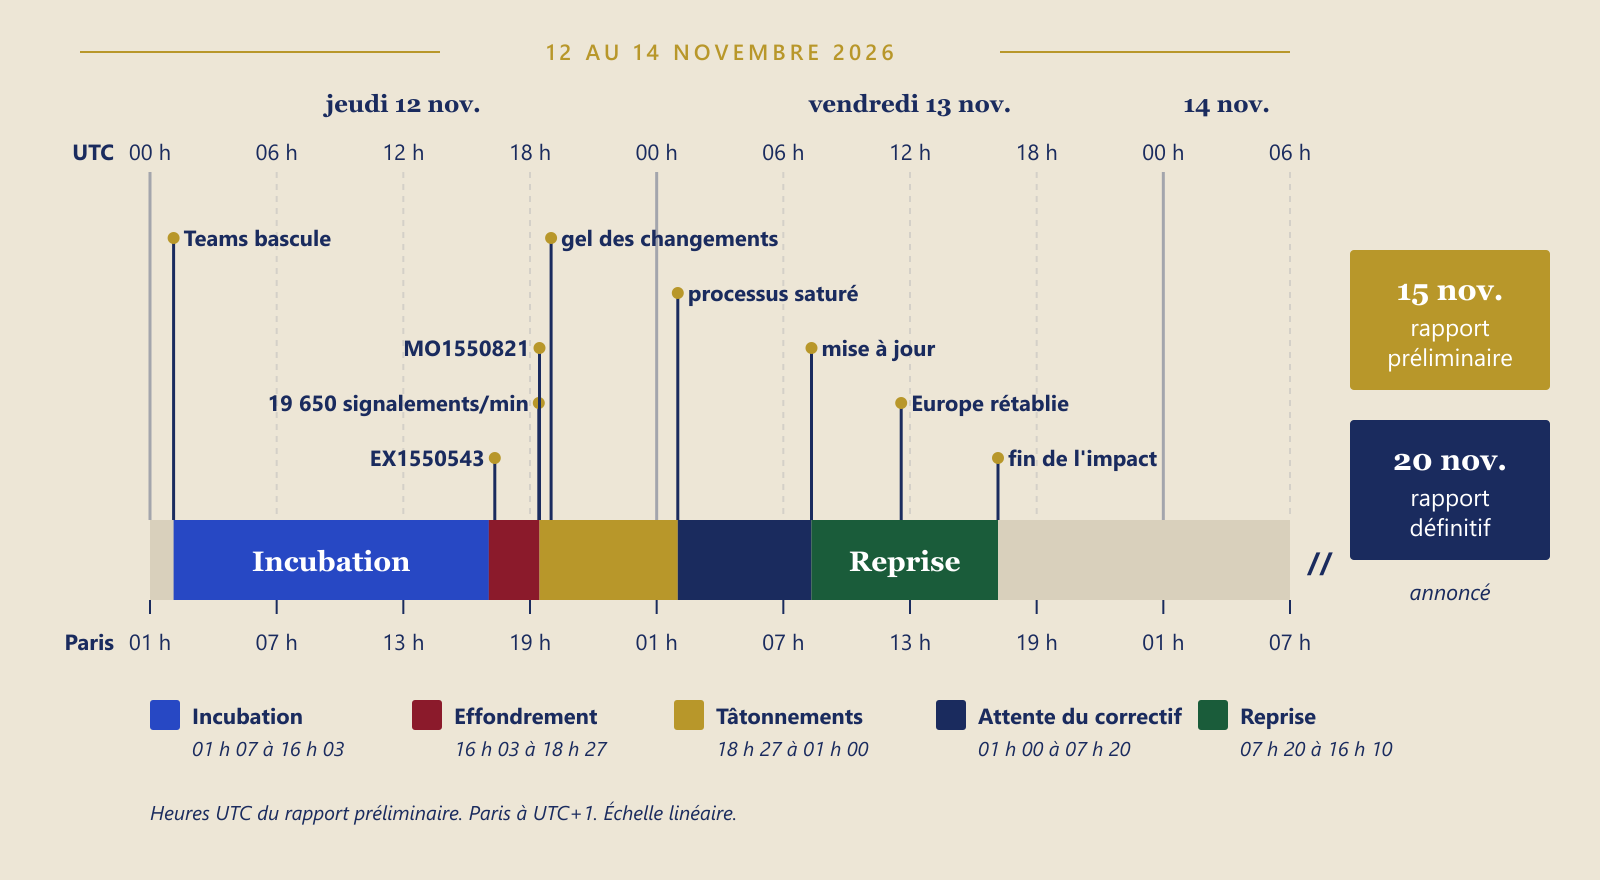 Schéma 3 : chronologie de l’incident en UTC et heure de Paris, d’après le rapport préliminaire.
Ce que Microsoft disait pendant la panne
The Register, qui suivait les messages de statut dans la nuit du 12 au 13 novembre, rapporte que Microsoft n’avait relevé aucun changement récent susceptible d’expliquer l’incident, puis qu’elle évaluait l’annulation d’un petit nombre de mises à jour de configuration récentes. SecurityWeek rapporte le lancement du retour arrière d’un changement de configuration réseau qui coïncidait avec le début de la panne. Le rapport préliminaire désigne un changement de code installé en juillet.
Les messages de la nuit décrivaient correctement le symptôme, des serveurs qui échouaient aux contrôles de santé automatisés. La cause a d’abord été cherchée parmi les changements récents. Elle se trouvait dans un changement vieux de quatre mois.
Le rapport ne masque pas cette nuit. Il note qu’à 22 h 00 UTC la télémétrie confirmait l’échec des actions engagées.
Les impacts mesurés
Côté services Microsoft 365
| Service | Ce qui ne fonctionnait plus | Source |
|---|---|---|
| Exchange Online | Accès aux boîtes (Outlook, Outlook sur le web, ActiveSync, API), distribution retardée | Rapport préliminaire |
| Teams | Fonctions liées à Exchange Online. Conversations et réunions fonctionnelles la majeure partie de l’incident | Rapport préliminaire |
| SharePoint, OneDrive, Office | Fonctions liées à Exchange Online, rétablissement partiel plus précoce | Rapport préliminaire |
| Copilot, Defender, Purview | Éléments en interaction avec Exchange Online. Defender for Office 365 cité par The Register | Rapport, The Register |
| Intune | Listé parmi les services touchés, accès d’administration perturbé selon The Register | Rapport, The Register |
| Fabric, Planner, Power Apps, To Do, Power BI, Universal Print | Listés sans détail | Rapport préliminaire |
Microsoft Entra ID ne figure pas dans la liste. Le rapport mentionne seulement, à 15 h 05 UTC le 13 novembre, après le transfert du trafic client éligible vers d’autres chemins de connexion, une amélioration « de la connexion et de l’accès aux services », sans dire s’il s’agit de l’authentification Entra ou de la connexion aux boîtes. Azure n’y figure pas davantage.
Côté Defender, les fonctions qui consomment le flux de messagerie, jusqu’au tri des messages signalés décrit dans mon article sur le Phishing Triage Agent, dépendent de la distribution du courrier, que le rapport dit retardée pour de nombreux utilisateurs. Aucune source consultée ne dit comment elles ont rattrapé le retard.
Ce que mesurent les tiers
Downdetector a publié le 12 novembre un relevé chiffré, la seule mesure tierce détaillée que j’ai pu vérifier. Les signalements sur Outlook ont commencé à grimper vers 17 h 25 UTC. À 18 h 25 UTC, cinq services Microsoft cumulaient 19 650 signalements par minute, contre moins de 15 un jeudi ordinaire, et Outlook a culminé à plus de 2 000 fois son niveau normal. Le seuil de détection était franchi dans 74 pays et territoires en une heure environ, et près de trois signalements sur dix venaient de l’extérieur des États-Unis entre 17 h 00 et 18 h 55 UTC. À 19 h 38 UTC, le rythme dépassait encore 11 000 par minute.
Le même relevé note que les signalements sur Azure ont été multipliés par cent environ, alors que l’historique de statut Azure ne contient aucun rapport post-incident pour ces deux jours. Downdetector mesure ce que les utilisateurs croient en panne.
Le chiffre de 430 millions, repris par la presse grand public, désigne selon la BBC la base mondiale d’utilisateurs de Microsoft 365, pas le nombre de personnes touchées. ThousandEyes, Cloudflare Radar et Kentik n’avaient publié aucune analyse au 16 novembre.
Côté organisations
Trois cas sont vérifiés à la source. Au Brésil, le Tribunal suprême fédéral a suspendu le décompte des délais de procédure des 12 et 13 novembre, avec reprise le 16, parce que les avocats ne recevaient plus par courriel les codes d’accès nécessaires au dépôt électronique de leurs actes. Au Royaume-Uni, les pharmacies ont perdu l’accès à la messagerie du NHS selon The Pharmaceutical Journal, et la National Pharmacy Association a prévenu de délais sur certaines ordonnances. En Australie, un associé de RSM Australia a estimé pour ABC News le coût à plusieurs centaines de milliers de dollars par heure pour les cabinets de services professionnels.
Wikipédia recense d’autres cas, que j’ai retrouvés dans les articles qu’elle cite. Le Guardian décrit des centaines d’hôpitaux, de cabinets et de services de santé du NHS perturbés, et des soignants revenus aux dossiers papier. La BBC rapporte le code gris (panne d’infrastructure) déclaré par le réseau hospitalier Unity Health Toronto, la perturbation de la plateforme informatique commune du gouvernement japonais, confirmée par Nippon.com, et l’avertissement de la Cour suprême des Philippines sur des réponses retardées. Restent à confirmer le chiffrage de 7 milliards de dollars attribué à Anderson Economic Group et le report des résultats de Richemont. Je n’ai trouvé aucune source sérieuse sur des impacts propres à la France.
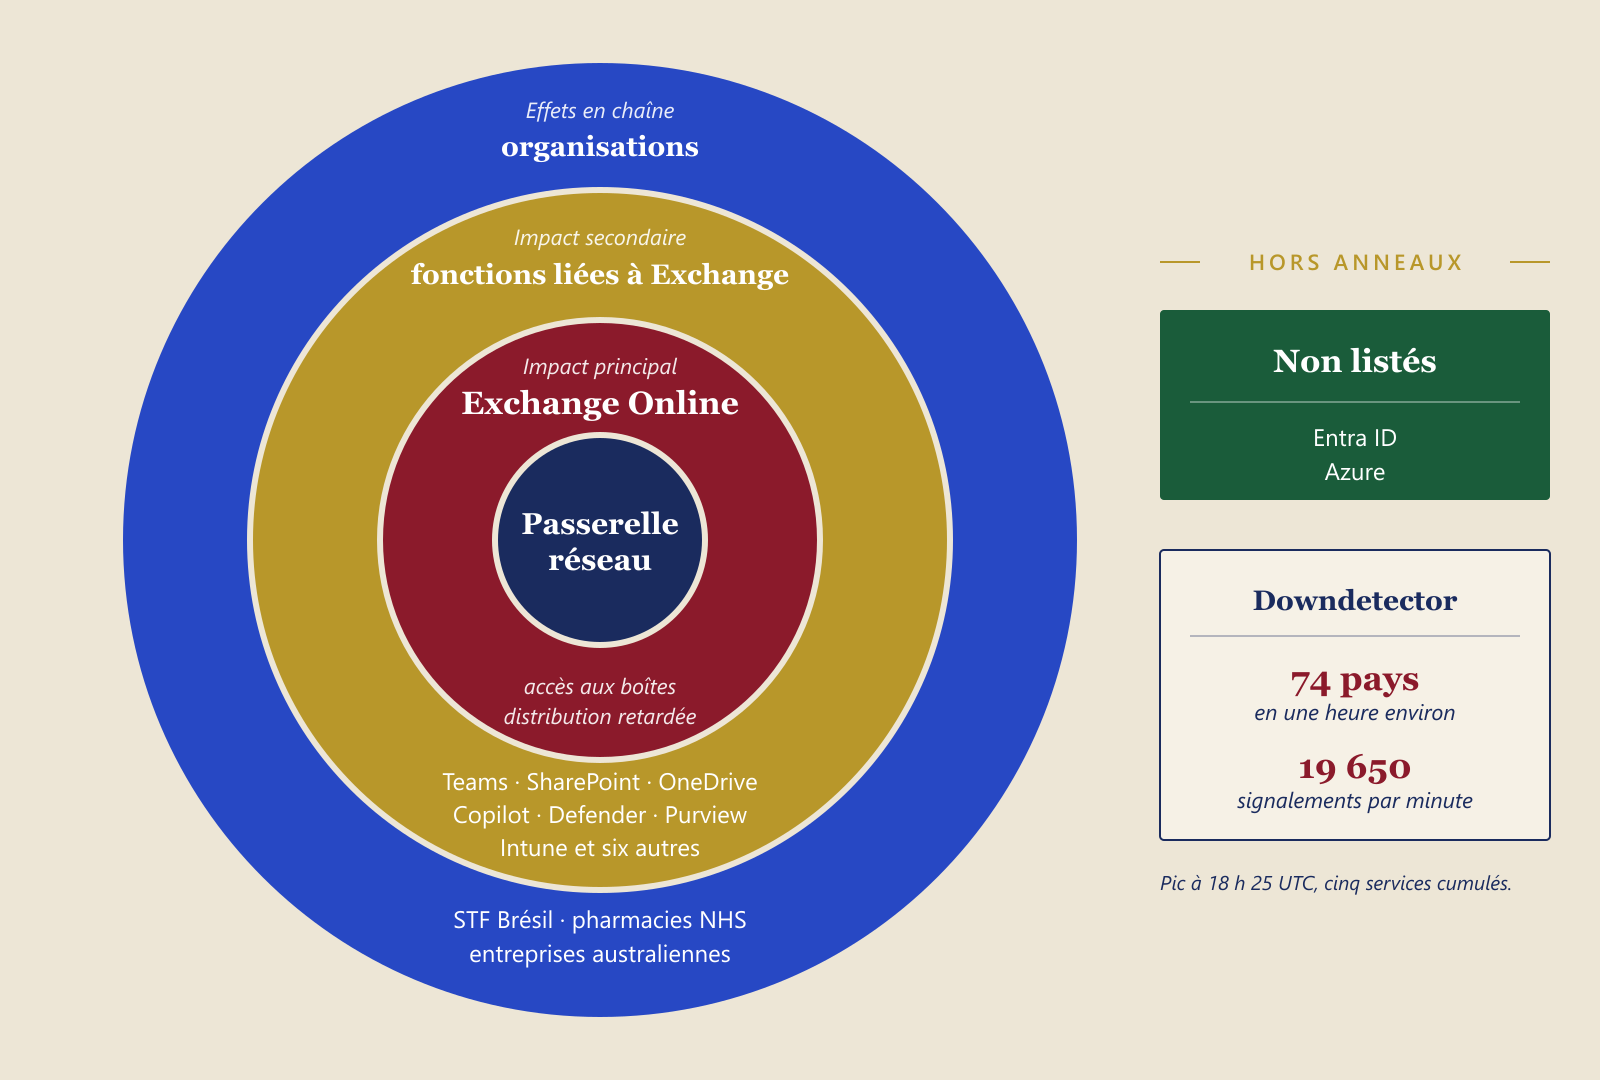 Schéma 4 : cartographie des impacts, de la passerelle aux organisations.
Ce que le rapport préliminaire ne dit pas encore
Le document du 15 novembre se déclare préliminaire. Il ne décrit pas le problème qui avait retiré 14 % des serveurs la veille. Il ne décrit pas le « problème distinct » qui a rendu les cloisons inopérantes, alors que c’est lui qui a fait d’une panne régionale une panne mondiale. Il ne précise ni les raisons d’échelle qui retiennent Exchange Online sur la passerelle, ni ce que Microsoft compte changer à cette dépendance.
Les mesures correctives tiennent en cinq lignes, toutes marquées terminées : la mise à jour qui rétablit le code antérieur, l’allongement du délai de distribution pour éviter les non-remises, l’ajout de capacité, une surveillance accrue des redirections et des connexions, des garde-fous sur la répartition du trafic. La liste complète est renvoyée au 20 novembre.
Le 12 novembre n’est pas un accident isolé dans l’année d’Exchange Online. Le 22 janvier 2026, une panne en Amérique du Nord a duré près de dix heures, selon The Register. Le 31 août, un problème de configuration de l’authentification interne d’Exchange Online a ouvert un incident étendu à Teams, SharePoint, Purview et Defender XDR, résolu le 3 septembre selon BleepingComputer. Les causes diffèrent. Le service qui tombe est le même.
Ce que l’incident enseigne aux administrateurs
Rien, dans cet incident, ne se corrigeait depuis un tenant. Tout ce qui l’entoure se prépare.
Suivre la santé du service hors du service
Le centre d’administration affiche l’incident sous Health > Service health. Microsoft Learn documente le recours quand il ne répond plus, la page publique status.cloud.microsoft et le compte @MSFT365Status sur X. L’application mobile Microsoft 365 Admin pousse aussi les notifications de santé.
Les notifications par courriel se règlent sous Customize > Email, avec deux adresses au plus par administrateur. Une alerte d’incident Exchange Online envoyée à une boîte Exchange Online risque d’arriver après la fin de l’incident. Je configure toujours la seconde adresse sur une messagerie hors du tenant.
Pour une supervision automatisée, Microsoft Graph v1.0 expose les incidents via GET /admin/serviceAnnouncement/issues, avec la permission ServiceHealth.Read.All, et le rapport post-incident via /issues/{id}/incidentReport dès sa publication. Un script qui interroge cet endpoint depuis une infrastructure indépendante de Microsoft 365 vous prévient dès la publication de l’incident. Le 12 novembre, EX1550543 a précédé de treize minutes le premier ticket client.
Prévoir un canal de crise hors de Microsoft 365
Teams a fonctionné pendant la majeure partie de l’incident, parce qu’il avait pu quitter la passerelle défaillante. Un plan de continuité qui compte sur Teams quand la messagerie tombe parie sur un détail d’architecture que le client découvre dans le rapport post-incident. Une liste d’appel, un canal SMS ou une messagerie tierce réservée à la cellule de crise coûtent moins cher.
Inventorier ce qui passe par le courriel sans être du courriel
Le dépôt électronique brésilien fonctionnait, et les avocats ne pouvaient plus s’en servir faute de recevoir le code envoyé par courriel. Codes à usage unique, validations d’achat, alertes de supervision, réinitialisations de mot de passe, notifications de signature : tout processus dont une étape attend un courriel dans une boîte Exchange Online a été bloqué ou retardé le 12 novembre, quel que soit le système qui l’héberge. Cet inventaire se fait à froid.
La sauvegarde du tenant n’y change rien. Entra Backup and Recovery protège la configuration contre une erreur ou une compromission, pas la disponibilité du service contre une panne de l’éditeur.
Geler ses propres changements
À 19 h 00 UTC, Microsoft a suspendu tous ses déploiements. La discipline vaut côté client. Modifier une stratégie d’accès conditionnel, un connecteur ou une règle de transport pour contourner une panne de l’éditeur ajoute une variable que personne ne peut mesurer, et un changement à défaire au retour du service.
Contrôler ce que la file d’attente a rendu
Microsoft indique avoir allongé le délai de distribution pour que les messages en file ne reviennent pas en non-remise. Vérifiez-le sur votre tenant par les traces de messages des flux critiques des 12 et 13 novembre, les non-remises éventuelles et les connecteurs entrants d’applications métier qui auraient abandonné après plusieurs tentatives. Téléchargez ensuite le rapport préliminaire, puis le définitif, pour votre registre d’incidents.
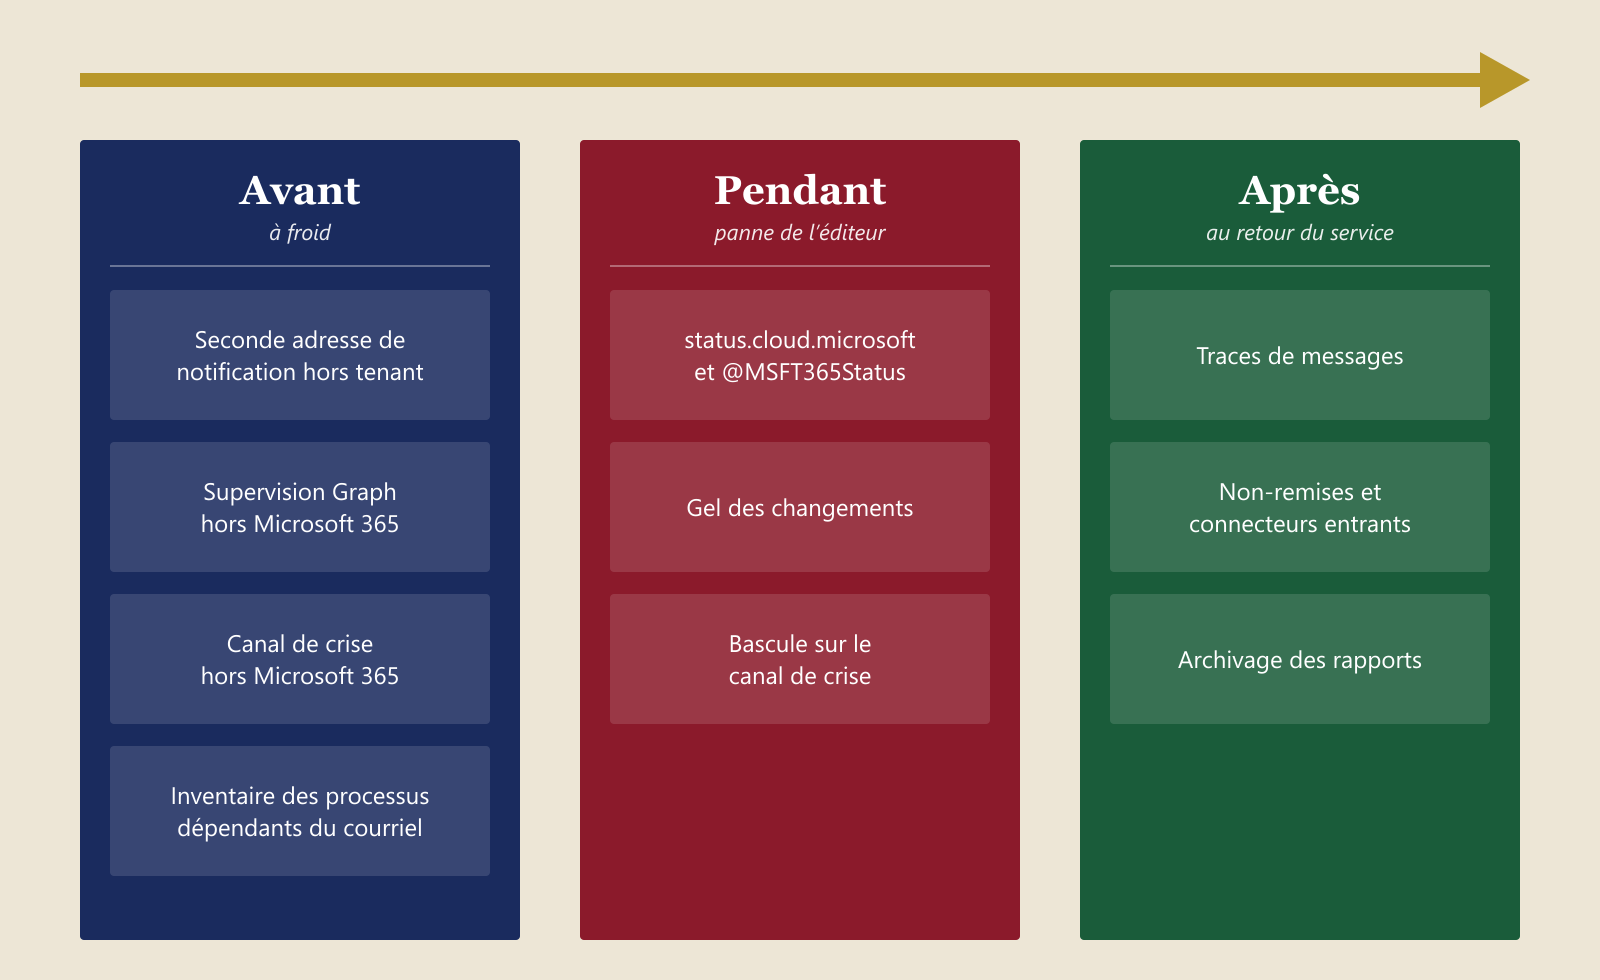 Schéma 5 : ce que l’administrateur prépare avant, fait pendant et vérifie après.
Synthèse
| Question | Réponse documentée |
|---|---|
| Quoi | Panne mondiale de la passerelle réseau devant Microsoft 365, impact principal sur Exchange Online |
| Identifiants | EX1550543 (Exchange Online), MO1550821 (Microsoft 365) |
| Quand | Du 12 novembre 2026, 16 h 20 UTC, au 13 novembre, 16 h 10 UTC |
| Cause | Défaut latent d’un correctif de juillet 2026, réveillé par la bascule de Teams et 14 % de capacité absente |
| Propagation | Redirection automatique, cloisons inopérantes, plus de 80 % des serveurs muets |
| Retour au service | Code antérieur rétabli par groupes de serveurs à partir de 07 h 20 UTC le 13 novembre |
| Attaque | Aucune preuve d’activité malveillante selon Microsoft |
| Action dans le tenant | Aucune pour la cause, vérifications de distribution recommandées |
| Prochaine échéance | Rapport définitif le 20 novembre 2026 |
Le rapport définitif est attendu le vendredi 20 novembre, avec la liste complète des mesures correctives. Deux questions restent ouvertes d’ici là : ce qui a percé les cloisons et pourquoi Exchange Online ne peut pas changer de passerelle.
Source
- Microsoft, Preliminary Post Incident Report for Microsoft 365, EX1550543 / MO1550821, 15 novembre 2026, centre d’administration Microsoft 365. Copie consultée : 365fanatic.com
- Microsoft 365 Status sur X, publication du rapport préliminaire, 16 novembre 2026
- Microsoft 365 Status sur X, fin du rétablissement, 14 novembre 2026
- Charles Lamanna sur X, version abrégée de la cause racine, 16 novembre 2026
- Azure status history
- Microsoft Learn, How to check Microsoft 365 service health
- Microsoft Learn, Graph v1.0, List issues
- Microsoft Learn, Graph v1.0, serviceHealthIssue: incidentReport
- Downdetector sur X, relevé du 12 novembre 2026
- The Register, 12 novembre 2026
- SecurityWeek, 12 novembre 2026
- Office Watch, 16 novembre 2026
- Cyber Security News, 16 novembre 2026
- Migalhas, suspension des délais par le STF, 13 novembre 2026
- The Pharmaceutical Journal, 13 novembre 2026
- ABC News, 13 novembre 2026
- Wikipédia (en), 2026 Microsoft outage (recensement des impacts, à confirmer source par source)
- The Register, panne du 22 janvier 2026
- BleepingComputer, panne Exchange Online du 31 août 2026